
Разработкакод · репозитории · документация
AI-станции, локальные модели, RAG и GPU-инфраструктура для работы с корпоративными данными внутри управляемого контура.
 NEUROSERVER
Сначала фиксируем задачи, модели, данные и количество пользователей. Затем под это выбираем оборудование, runtime, RAG и интеграции.
 01Оборудованиестанция · GPU · сервер
 02Модели и средаLLM · runtime
 03Данные / RAGисточники · индекс
 04Программный слойAPI · интерфейсы
 05 / ВНЕДРЕНИЕПроверка и передача
AI-станцию, GPU-рабочую станцию или сервер выбираем под модель, память, нагрузку и число пользователей.
Готовим runtime, зависимости и локальные модели, затем фиксируем рабочую конфигурацию.
Подключаем документы и базы знаний, настраиваем индекс, поиск и права доступа.
Подключаем Control Center, интерфейсы, API и нужные внутренние системы.
Проверяем реальные сценарии и передаём готовую конфигурацию с правилами эксплуатации.
Не набор отдельных компонентов, а одна рабочая система: оборудование, модели, данные и программный слой уже согласованы между собой.
ВРЕМЕННОЕ ИЗОБРАЖЕНИЕЗАМЕНА ПОСЛЕ ПОДТВЕРЖДЕНИЯ
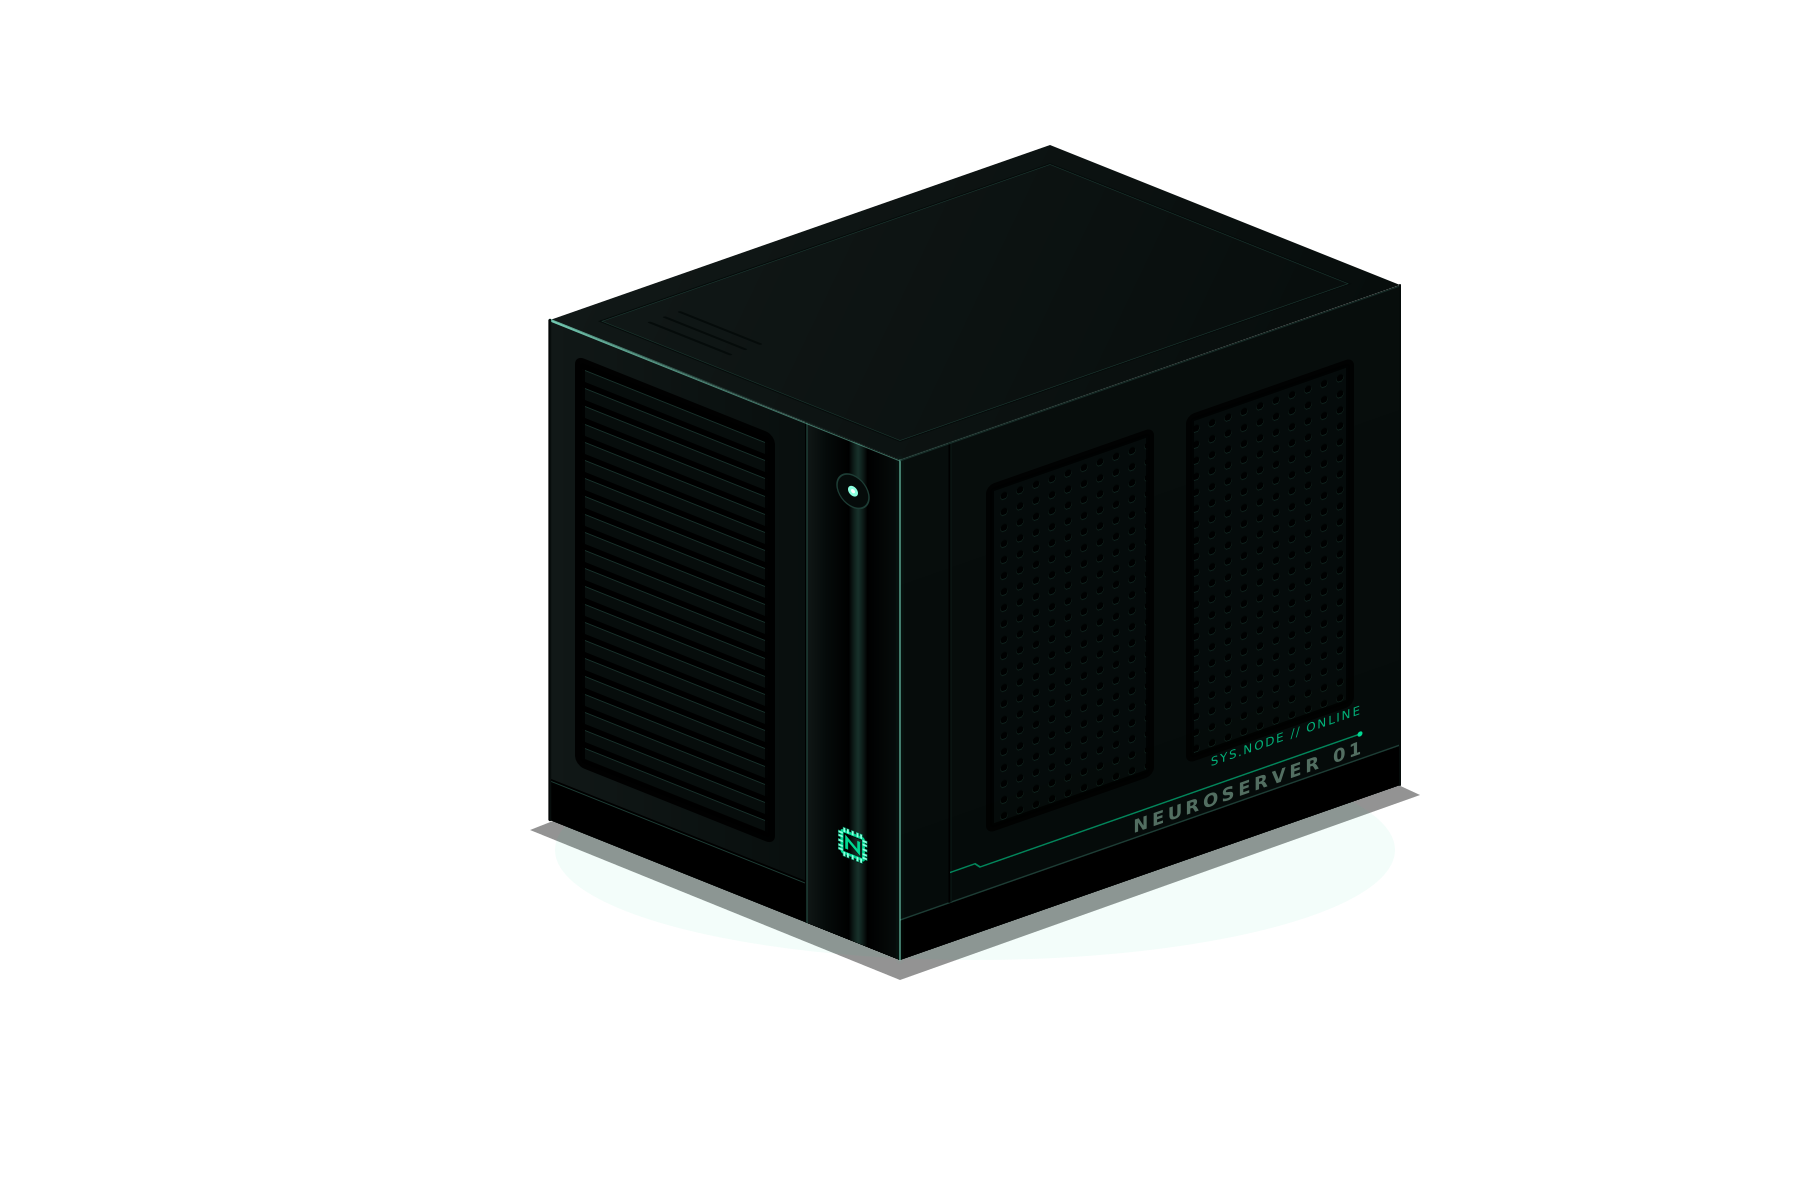
NEUROSERVER AI Station — компактная локальная платформа на AMD Ryzen AI Max+ 395 с 128 ГБ unified memory. Подходит для локальных LLM, RAG, разработки и внутренних AI-сервисов.
Финальная ревизия комплектующих и программный профиль фиксируются перед поставкой. Доступная моделям память зависит от ОС, runtime и распределения unified memory.
Всё необходимое для первого рабочего запуска.
ОборудованиеАппаратная конфигурация под задачу.
СредаДрайверы, runtime и зависимости.
МоделиУстановка и рабочий профиль.
Данные / RAGИсточники, индекс и поиск.
Control CenterИнтерфейс локальной AI-среды.
 Внедрение
Проверка, передача и старт.
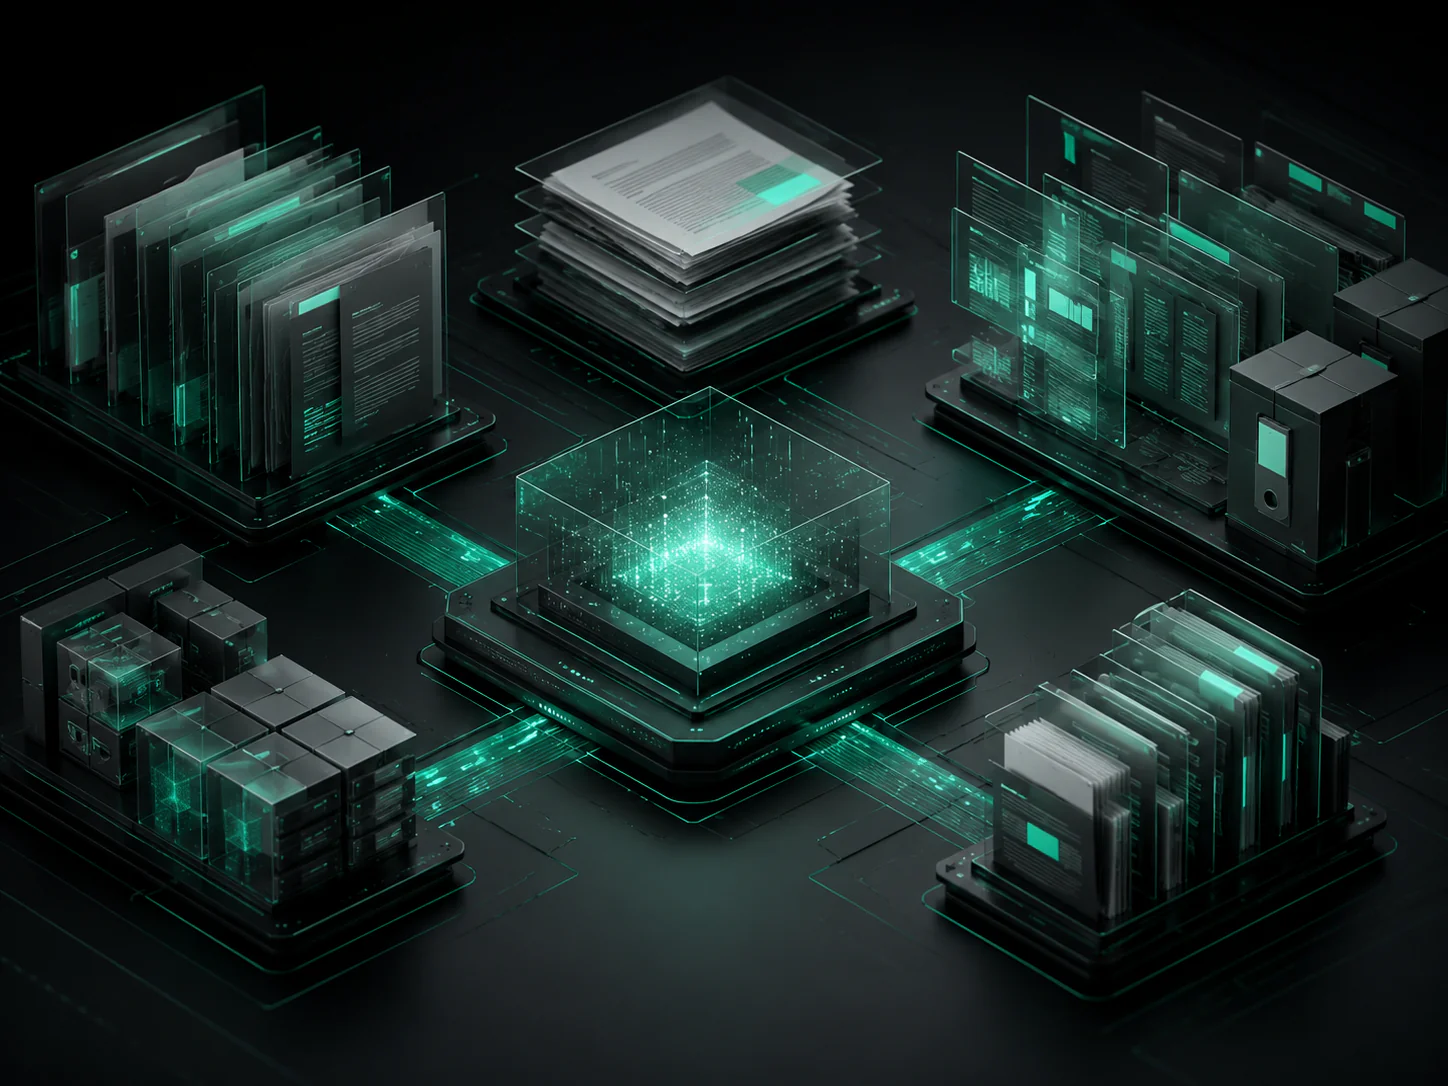
Регламенты, инструкции, договоры и базы знаний можно подключить к локальному поиску. Модель получает найденный контекст и отвечает с опорой на внутренние материалы.
Документы не обязательно отправлять во внешний AI-сервис. Источники, индекс и поиск можно держать внутри инфраструктуры компании.
Внешний API можно подключить только там, где он действительно нужен. Какие данные ему разрешено передавать, определяется отдельно.
 ДОКУМЕНТЫ / ЗНАНИЯ / ИСТОЧНИКИ
RAG снижает вероятность ответа без контекста, но не гарантирует правильность результата. Критичные ответы нужно проверять.
Локальный запуск нужен не ради самого факта. Он имеет смысл, когда важны контроль данных, постоянная нагрузка, стоимость внешнего API или работа без облака.
Диалог, анализ и черновики с внутренним контекстом в инфраструктуре компании.
Control Center — интерфейс управления станцией и локальной AI-средой: состояние системы, профили, модели и RAG в одном окне.
Фиксируем конфигурацию станции, runtime и рабочий профиль, затем проверяем согласованные сценарии.
Следующие уровни программного слоя расширяют управление и наблюдаемость среды.
Начните с конфигурации под один рабочий сценарий. По мере роста моделей, данных и числа пользователей добавляются выделенные вычисления, хранение и общие сервисы.
Локальные модели, RAG и первый рабочий сценарий для одного пользователя или группы.
Дискретный GPU для более тяжёлых моделей, разработки и интенсивной локальной работы.
Отдельный слой, когда растут объём источников, индексы и корпоративная база знаний.
Несколько пользователей, команд или AI-сервисов работают на общей системе.
Несколько узлов, доступы и эксплуатация объединяются в одну архитектуру.
Модели, данные и интерфейсы подбираются под то, как команда действительно будет работать.


NEUROSERVER связывает железо, модели, данные и рабочую среду. Команда получает систему, которую можно запустить сейчас и масштабировать при росте нагрузки.
Оборудование, модели и данные согласованы до запуска.
Конфигурацию выбираем после того, как понятны модели, пользователи и нагрузка.
Рабочий сценарий прогоняется на конкретной конфигурации.
При росте нагрузки можно перейти от одной станции к серверной инфраструктуре.
Сначала фиксируем результат и ограничения. Затем собираем, проверяем и передаём рабочую конфигурацию.
Фиксируем пользователей, данные, модели и ожидаемый результат.
Определяем класс системы, память, GPU, хранение и точки доступа.
Собираем runtime, модели, данные и нужные интеграции.
Прогоняем реальные рабочие сценарии на целевой системе.
Фиксируем конфигурацию и правила дальнейшей эксплуатации.
Коротко о моделях, данных, оборудовании и подготовке системы.
Локальный ИИ запускает модели и связанные сервисы на инфраструктуре, которую контролирует компания. Размещение данных, доступы и допустимые внешние подключения определяются архитектурой проекта.
AI-станция подбирается под постоянный инференс и высокую нагрузку на память. Важны не только CPU и GPU, но и доступная память, охлаждение, runtime и проверенная программная конфигурация.
Unified memory — общий пул памяти для вычислительных блоков платформы. Это позволяет размещать более крупные модели, но фактически доступный объём зависит от ОС, runtime и системного распределения памяти.
Состав моделей зависит от объёма памяти, квантования, длины контекста и выбранного runtime. Модель подбирается под задачу и проверяется на целевой конфигурации.
Да. Регламенты, инструкции, договоры и базы знаний можно подключить к локальному поиску с учётом прав доступа и ссылками на использованные материалы.
RAG находит релевантные фрагменты во внутренних источниках и передаёт их модели вместе с запросом. Ответ можно связать с документами, на которых он основан.
Да, если источник можно безопасно читать, обновлять и индексировать. До запуска определяются структура данных, качество поиска и правила доступа.
Для локального инференса интернет не обязателен. Подключение может понадобиться для обновлений или разрешённых внешних сервисов — это настраивается отдельно.
Она нужна, когда требуется дискретный GPU, CUDA, генерация изображений, обучение или более тяжёлые модели. Конфигурация зависит от конкретной нагрузки и рабочего стека.
GPU-сервер имеет смысл для общего вычислительного ресурса, нескольких команд или постоянно работающих AI-сервисов. Он также даёт больше возможностей для масштабирования и эксплуатации.
Да. Для пилота, рабочей группы или одного направления это практичный старт без преждевременного усложнения инфраструктуры.
Да. При росте нагрузки можно добавить хранение, выделенный GPU, серверные узлы и общие сервисы, сохранив проверенный рабочий сценарий.
Возможность зависит от интерфейсов станции, корпуса, питания, драйверов и выбранного программного стека. Такой вариант проверяется как отдельная конфигурация.
Мы готовим runtime, драйверы, зависимости и выбранные модели, затем прогоняем согласованные сценарии. Команда получает зафиксированную конфигурацию и базовые правила эксплуатации.
Опишите модели, данные, число пользователей и рабочие сценарии. Этого достаточно, чтобы определить класс оборудования, память, GPU, хранение и программный слой.